图纸审查靠总工熬通宵?报告审查AI把审图从经验变成清单
某甲级设计院的施工图审查出图前夜,项目总工把全专业图纸摊了一桌子。建筑专业的防火分区面积超出规范上限、结构专业的梁高和暖通风管打架、给排水的消火栓布置违反消防规范、电气的配电箱位置和建筑门窗冲突。总工靠三十多年的经验一条条找,到凌晨四点眼睛已经花了,最后还是在审图公司被打回来三条强条。这个场景在设计院反复上演:审图靠的是总工的脑子和熬夜,年轻工程师审不动,老工程师熬不住。这篇从工程角度拆解,报告审查AI怎么把图纸审查从"凭经验"变成"按清单销项"。
一、施工图审查为什么是设计院最难自动化的环节
先把审查对象说清楚。施工图审查不是看一份文档,是看一套互相约束的专业图纸——建筑、结构、给排水、暖通、电气、智能化,每个专业几十张到上百张图,加起来几百张。强条(强制性条文)藏在每本规范里,一本《建筑设计防火规范》就有几百条,违反任何一条都要打回重画。审查的难点有三个。第一是规范多且更新快:强条分散在几十本规范里,每年还有局部修订,总工的"脑子里的规范库"总有遗漏。第二是跨专业冲突:单看每个专业图都没问题,但合在一起就打架——梁高挡了风管、消火栓挡了疏散门,这类冲突只看一个专业发现不了。第三是错漏碰缺:尺寸标注前后不一致、详图与平面图对不上、设备编号重复,这些低级错误量大但必须找出来。这三个难点决定了,审图不能只靠规范条文的简单匹配,必须把图纸内容结构化、把跨专业关系抽出来、把审查逻辑变成可执行的规则。
二、第一步:把图纸变成机器能读的结构化数据
AI 审图的前提是图纸数字化。设计院出图用的是 DWG,文件本身是矢量格式,几何信息和图层信息都在,但"这根线是墙还是梁"这个语义需要靠图层命名和图块定义来判断。工程上的做法是:解析 DWG 的图层体系,按设计院的图层标准(比如墙图层、柱图层、风管图层、管道图层)把图元分类;提取尺寸标注、文字标注、图块属性;把平面位置信息(坐标)和语义信息(这是什么构件)关联起来。这一步的产物是一个结构化的"图纸数据库":每个构件有类型、位置、尺寸、属性,构件之间有空间关系(距离、包含、相交)。
这一步的坑在于图层不规范。很多设计院的图层命名是历史遗留,"wall"、"墙"、"W-1"、"图层1"混在一起,AI 靠规则判断容易错。更稳妥的做法是先做一次图层治理:用样本图纸训练分类模型,把图元自动归到标准类别,人工只复核不确定的。另一个坑是图块嵌套——设计院的图块里常套着子图块,子图块里还有图块,解析时要递归展开,否则设备数量统计会严重失真。图纸治理做不到位,后面所有审查规则都跑不准——因为"墙"都识别错了,防火分区面积怎么算都是错的。
三、强条审查:把规范条文变成可执行规则
强条审查是审图的硬骨头。以《建筑设计防火规范》为例,"民用建筑的防火分区最大允许建筑面积不应大于2500平方米"这条,要变成可执行规则需要四步。第一步是规范解析:把自然语言条文拆解成条件和结论——条件是"民用建筑",结论是"防火分区面积≤2500㎡",还要加上例外条款(设置自动灭火系统可翻倍)。第二步是数据匹配:从图纸数据库里找出防火分区的边界(防火墙、防火门),计算每个分区的面积。第三步是规则执行:判断面积是否超标,同时检查是否有自动灭火系统来决定是否适用例外条款。第四步是输出结论:如果超标,标注违规位置、违反的条文编号、建议修改方向。
这个过程的关键不是大模型,是规则引擎。大模型擅长理解自然语言条文,但判断"面积2501㎡是否超标"必须是确定性计算,不能让模型"猜"。正确的分工是:大模型负责把规范条文解析成规则(人工复核确认),规则引擎负责在图纸数据上执行规则,输出可解释的结论。大模型知识库RAG在这里的价值是规范条文库——审查员在复核结论时,系统调出对应的条文原文、条文说明、历史案例,而不是只给一个"违规"标签。这一点和智能文档检索系统的能力是复用的:规范库本质上就是一个高专业度的检索场景。
四、跨专业冲突检测:把"合图"变成空间关系计算
跨专业冲突是总工熬夜的主要原因。传统做法是"合图"——把各专业图纸叠在一起,人工找重叠。这个过程极其耗时,而且人眼会漏。AI 做法是空间关系计算:基于结构化的图纸数据库,对不同专业的构件做空间碰撞检测。比如结构梁和暖通风管的碰撞,就是两个三维长方体(梁和风管)在空间中是否相交;消火栓和疏散门的冲突,就是消火栓箱的位置是否落在疏散门的开启范围内。
空间碰撞检测的技术本身不复杂(三维几何求交),难点在于"哪些碰撞是真问题"。梁和风管相交如果是设计预留的穿梁套管,就不算冲突;管道交叉如果有标高差,也不算冲突。所以碰撞检测之后要有一层"过滤":按规则区分硬冲突(必须改)和软冲突(需复核)。比如同专业同系统的管道交叉且无标高差是硬冲突,不同专业管道交叉且标高差小于净距要求是软冲突。还有一个常见误区是把所有碰撞都当问题报——一整套施工图可能报出几千个碰撞点,其中大部分是软冲突或设计预留,总工根本看不过来。碰撞分级过滤的目标是把硬冲突控制在几十个以内,让总工能逐条复核,而不是淹没在几千条无意义告警里。过滤规则来自审图公司的审查要点和设计院的内部标准,这部分需要长期积累。步天AI在跨专业审查里提供了构件空间关系计算、碰撞分级过滤和冲突位置标注,每条结论带构件ID和图纸坐标,审查员点一下就能跳转到原图位置。
五、错漏碰缺:用一致性校验消灭低级错误
除了强条和冲突,施工图里大量的低级错误是"错漏碰缺"——尺寸标注前后不一致、详图索引和详图对不上、设备编号重复、材料表和图纸数量不符。这些错误不违反强条,但会导致施工方理解错误,轻则返工重则出事故。这类问题最适合用规则校验:平面图上标注的尺寸和详图上的尺寸做比对,不一致就标红;设备编号在数据库里查重,重复就报错;材料表的数量和图纸上的图块数量做统计比对。这一层校验不需要大模型,纯粹是数据一致性检查,但它的产出量往往占审图意见的一半以上。把这部分自动化,能释放总工大量精力去看真正需要专业判断的问题。
六、审查报告的生成:从清单到可追溯结论
审查的最终产出是一份审查报告,列出所有问题、位置、违反的条文、修改建议。传统报告是审查员手写或填表,格式不统一、描述不精确。AI 审查的产出是结构化的问题清单:每条问题有类型(强条/冲突/错漏)、位置(专业、图号、坐标)、违反条文(规范编号+原文)、严重等级、建议修改。这份清单可以一键导出成审查报告,每条结论都可追溯到原图位置和规范原文。
这里要强调 AI 的边界:系统列出来的是"疑似问题清单",不是"最终审查意见"。总工的价值是判断哪些疑似问题是真问题、哪些是误报、哪些虽然违反字面条文但有合理例外。AI 把总工从"找问题"解放出来,专注于"判断问题"。这个边界不能模糊——一旦让 AI 直接出最终审查意见,出了问题责任说不清,总工也不会信任系统。
七、落地路径:从一个专业、一类问题开始
施工图审查的全面自动化是个长期工程,落地不能贪大。第一步是选一个专业、一类问题做试点——比如建筑专业的防火分区面积强条。把《建筑设计防火规范》里关于防火分区的条文全部解析成规则,在历史图纸上回归测试,用总工审查过的图纸做标准答案,目标是规则能命中总工发现的所有问题,误报率控制在20%以内。达标后再扩展到其他强条,再扩展到跨专业冲突,最后覆盖错漏碰缺。
整个过程的关键资产是"规则库"和"误报案例库"。规则库是已经解析成可执行规则的规范条文,误报案例库是系统报了但总工判断没问题的情况——这些案例用来优化规则的过滤逻辑。规则库和误报案例库越积累,系统的命中率越高、误报越低,这是一个滚雪球的过程。步天AI在施工图审查场景提供了规范条文解析、规则引擎执行、跨专业碰撞检测、错漏碰缺校验和审查报告生成,支持规范库的持续更新和规则的可视化配置,支持私有化部署和细粒度权限管控。
补充阅读:文档智能审查在建筑工程行业的应用实践;AI知识库系统答不准:问题多半出在检索链路
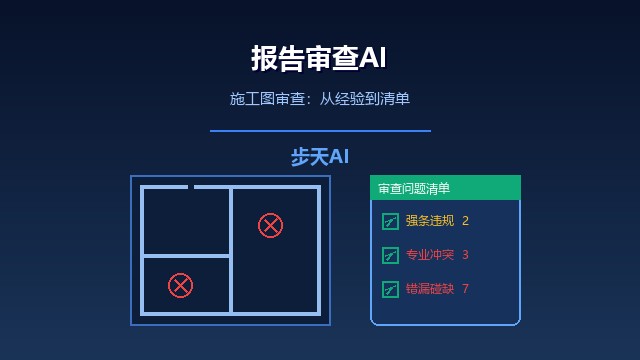
回到那位熬通宵的总工。系统上线半年后,他在一次内部交流上说了句话:"以前审图靠我脑子里的规范库和一双熬夜的眼,现在系统把清单列出来,我只负责判断。我终于不用靠失眠来保质量了。"这句话点破了AI审图的本质——不是替代总工的专业判断,是把总工从重复劳动里解放出来,让判断更专注。
延伸阅读:
报告审查AI如何降低底稿复核压力
大模型知识库RAG的落地路径与常见误区
AI知识库为什么那么多?一个企业三套库的真实成因
上一篇:没有了. 下一篇:没有了.