AI知识库为什么那么多?一个企业三套库的真实成因
某制造业集团的信息部年底做了一次盘点,结果让自己都意外:全集团已经上线了七套知识库——法务合同审查库、研发技术规范库、销售案例库、生产操作库、客户服务知识库、财务政策库、人力资源制度库。每套库都有独立的文档、独立的权限、独立的运维。信息部的第一反应是"太浪费了,合并成一个"。但他们用了三个月尝试合并,最终不了了之。原因不是技术做不到,是每一套库存在的逻辑都不同,硬合并之后,没有一套好用。这个案例不是孤例。AI知识库系统为什么那么多?答案不在厂商端,在企业端——不是企业想建这么多,是不同的知识场景逼着它们必须分开。
一、三套库的检索目标,根本不一样
以法务合同审查库、研发技术规范库、销售案例库为例,表面上都是"把文档塞进库让大家查",但底层的检索逻辑完全不同。法务库的检索目标是精确匹配——查的是"合同条款里有没有这句话"、"这个表述在之前哪份合同里出现过"。法务人员需要的是原文级别的命中,一条条款的漏检可能导致合同漏洞。研发库的检索目标是概念扩散——工程师查的是"这个技术问题有没有类似方案",他不在乎原文一字不差,在乎的是语义相近的思路和做法。销售库的检索目标是场景匹配——销售查的是"有没有跟这个客户行业、规模、痛点类似的成交案例",他用的语言是业务语言,不是文档里的技术语言。
这三种目标对应的检索策略是冲突的。法务库要精确,向量召回的模糊匹配反而会引入干扰;研发库要扩散,只靠关键字检索漏一大片;销售库要场景匹配,需要把客户的自然语言问题翻译成知识库能理解的查询词。如果硬塞进一个库,要么精确场景被模糊匹配拖累,要么扩散场景被关键字卡死。这就是为什么"一个大库"听起来合理,实际没人能用好。不同的知识类型,需要不同的智能文档检索系统配置。
二、数据本身的差异,决定了分库的必要性
除了检索目标,数据本身的四个差异也决定了分库的合理性。第一是时效性差异:生产操作库的内容每天都在更新(操作SOP、设备参数调整记录),而财务政策库可能一年只更一次(年度财务制度、税务政策汇编)。把高频更新和低频更新的文档放一个库,索引重建策略不好定——按高频来,低频内容被反复重建浪费资源;按低频来,高频内容迟迟不入库。第二是结构化程度差异:财务政策库大量是表格化数据(税率、费用标准、审批额度),研发库大量是非结构化技术文档。两者的切分策略、抽取规则、元数据模型都不同。第三是文档体量差异:销售案例库一份文档几KB,研发规范库一份技术手册几百MB,入库处理耗时天差地别。第四是语言风格差异:法务文档用法律术语,销售文档用口语化表达,同一个向量模型在两种语料上的检索效果不一样,需要不同的嵌入模型或微调。这些差异不是"统一规范"能解决的,强行统一只会让所有场景都打折。还有一个常被忽略的差异是文档生命周期:法务合同有明确的版本和效力状态(草稿、已签、已废止),废止的合同条款绝不能被检索出来作为现行依据;而销售案例库的案例没有"废止"概念,只有"是否仍有参考价值"的模糊判断。这两种生命周期管理逻辑完全不同,混在一个库里,要么废止合同被误用,要么案例被过度标记下线。
三、多知识库的真正挑战:检索路由与知识边界
承认分库合理之后,新的问题出现了:用户查一个问题时,系统怎么知道该去哪个库查?这就是检索路由。企业级大模型知识库RAG架构里,检索路由是必须解决的核心问题。简单的做法是让用户自己选库,但这要求用户知道自己的问题属于哪个领域——而很多时候用户恰恰不知道。一个销售问"客户问我们产品是否符合某行业法规,怎么回答",这个问题可能同时涉及销售案例库(有没有类似答复)、法务库(法规原文)、研发库(产品合规认证)。好的检索路由要自动判断问题的领域分布,把查询分发到相关的多个库,再把各库的结果合并排序。
合并排序是另一个难点。不同库的打分基准不同——法务库的相似度0.8可能表示条款高度吻合,研发库的0.8可能只是思路相近。直接按分数合并排序会乱序。工程上的做法是每个库有自己的打分校准,或者引入统一的重排模型对跨库结果做二次排序。还有知识边界问题:同一个概念在不同库里有不同的定义(比如"客户"在销售库里是签约甲方,在法务库里是合同相对方,在客服库里是服务对象),跨库引用时必须标注来源库和该库内的定义,否则会出现歧义。这些工程细节,是"多知识库"能不能真正用起来的分水岭。
四、正确的架构:联邦检索,不是物理合并
既然合并不了,正确的做法是什么?答案是联邦检索——各库保持物理独立,在检索层做统一入口。具体架构分三层。第一层是统一检索入口:用户只面对一个搜索框,不需要知道背后有几个库。第二层是检索路由与调度:路由器根据问题语义判断涉及哪些库,并发发起检索,收集各库返回的候选结果。第三层是统一重排与展示:用一个共享的重排模型对跨库候选做统一排序,展示时标注结果来源库和文档类型,点击后跳转到对应库的原文。
这种架构的好处是每个库可以按自己的节奏优化——法务库可以换更适合法律文本的嵌入模型,研发库可以增加代码片段索引,互不干扰。同时用户体验是统一的,不需要在多个系统间切换。联邦检索的前提是各库遵循统一的接口规范(返回结果的字段、格式、引用方式),这个规范是架构的地基。如果各库各自为政、接口不统一,联邦检索就是空谈。步天AI在多知识库场景提供了统一检索路由、跨库重排和来源标注,支持各库独立配置嵌入模型与索引策略,整体支持私有化部署。
五、权限与安全:多库架构下的硬约束
多库架构下,权限问题比单库复杂得多。一个用户可能在法务库有只读权限、在研发库有编辑权限、在财务库完全无权。检索时必须先做权限过滤,再做检索——不能检索完了再判断用户能不能看(那样关键词和片段已经泄露了)。这要求每个库的权限元数据在检索前就参与过滤,技术上叫"pre-filter"。还有审计留痕:跨库检索时,用户的每次查询、每个库的返回结果、每次点击都要记录,这在合规审查时是必须的。另外,有些库的内容不能被其他库的检索触达——比如并购项目中的保密合同,只在法务库的受限空间里,路由器不能把查询分发进去。这些权限和安全约束,是多知识库架构不能回避的硬约束,也是很多企业"想合并但合并不了"的深层原因。
六、落地路径:先建目录,再建联邦
如果企业已经有多套知识库在跑,落地路径不建议上来就搞联邦检索。第一步是建"知识库目录"——把所有库的基本信息列出来:每个库的主题、文档范围、更新频率、负责人、可访问人群。这一步的目的是让企业知道自己到底有多少知识资产,很多企业盘点完才发现重复建设严重——同一个主题在两个部门各建了一个库。第二步是清理重复:能合并的先合并(主题完全重叠、权限一致的),不能合并的保留。第三步才是联邦检索:对保留下来的库,统一接口规范,上检索路由和跨库重排。第四步是持续治理:定期评估每个库的活跃度,长期无人访问的库归档或下线,避免知识库无限膨胀。整个过程的核心不是技术,是治理——没有明确的库负责人和更新机制,联邦检索架得再漂亮,里面装的也会是过期内容。治理到位了,多库是资产;治理缺位,多库就是负担。
七、回到最初的问题:为什么那么多
绕了一圈,答案其实很朴素:AI知识库之所以那么多,不是因为企业喜欢重复建设,也不是因为厂商忽悠,而是因为知识本身就是分场景的。法务的精确、研发的扩散、销售的场景匹配,这些需求天然矛盾,一套配置满足不了。强行合并的代价是所有场景都打折,而分库的代价是架构复杂——企业最终都选择了后者,因为"都能用"比"都不好用"重要。真正的解法不是消灭多库,是在多库之上架一层联邦检索,让复杂性对用户隐形。理解了这一点,再看企业里那七八套知识库,就不会觉得是浪费,而是不同知识场景各自找到的最优解。
补充阅读:AI知识库系统为何遍地开花;AI知识库系统答不准:问题多半出在检索链路
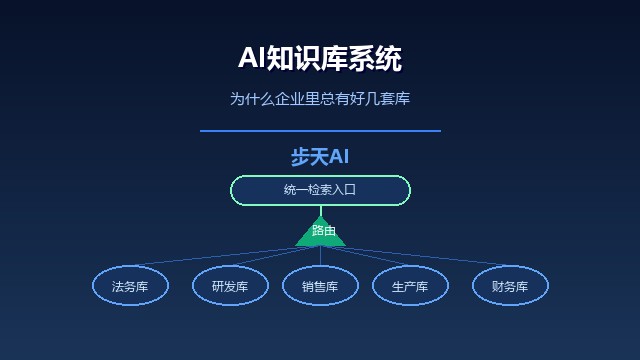
回到那家制造业集团。三个月合并失败后,信息部换了思路:不再强求合并,而是给七套库做了目录、统一了接口、上了联邦检索。半年后回访,员工的反馈是:"以前查个问题要在七个系统里翻,现在一个框都能搜到,还能看到是哪个库来的。"信息部总监说了句话,很实在:"知识库多不是病,查不到才是。"这句话,大概就是"为什么那么多"最务实的注脚。
延伸阅读:
企业知识库管理系统的选型要点
大模型知识库RAG的落地路径与常见误区
AI知识库的下半场:从查资料到撑起一场主题讨论
上一篇:没有了. 下一篇:没有了.